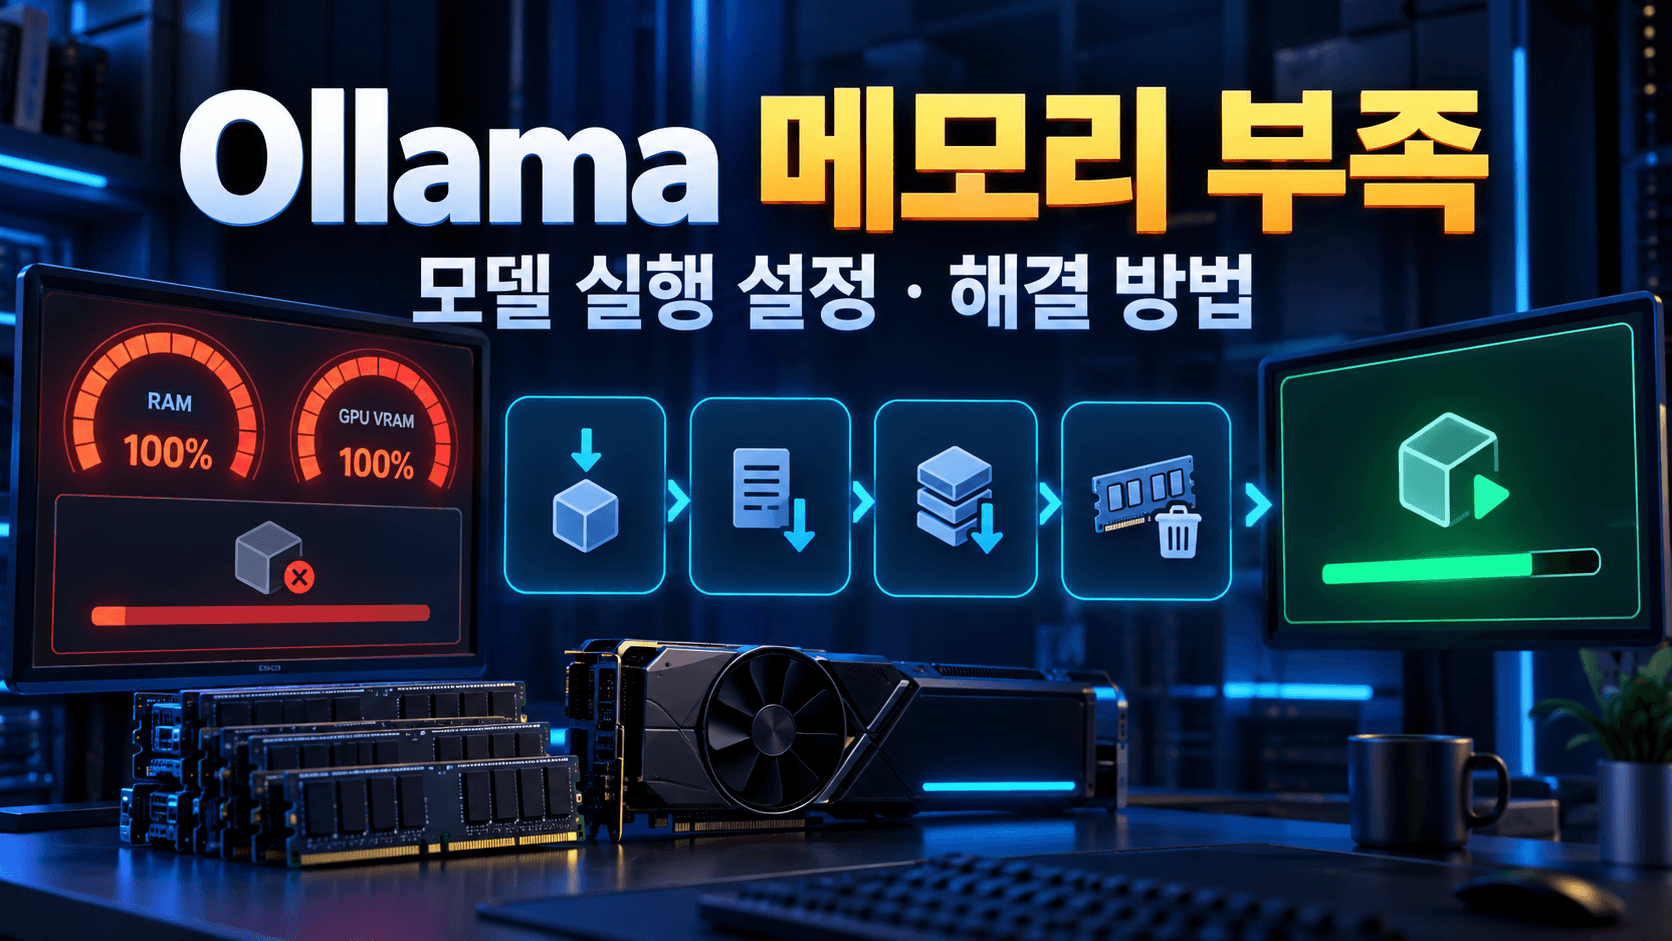
Ollama 메모리 부족 오류: 모델 실행을 위한 설정 방법
Quick Answer
먼저 보는 핵심 답변
Ollama 모델 실행 중 RAM·VRAM 부족이나 runner 종료가 발생할 때 모델 크기, context, 병렬 요청, 상주 시간과 WSL·Docker 메모리 설정을 진단하고 조정하는 방법입니다.
Search Intent
이 글에서 해결할 문제
- 이런 분께
- Ollama out of memory, 모델 로드 실패, RAM 또는 VRAM 부족 원인을 찾아 낮은 메모리에서도 모델을 안정적으로 실행하려는 사용자
- 읽고 나면
- 현재 모델의 CPU·GPU 배치와 context를 확인하고, 작은 모델·context 4K·단일 요청부터 안전한 실행 기준선을 만든 뒤 장비별 메모리 임계점을 기록할 수 있습니다.
- 다루는 범위
- GPU가 정상 인식된 뒤 발생하는 RAM·VRAM 할당, context, K/V cache, 병렬 요청과 모델 상주 문제에 집중합니다. GPU discovery와 CUDA 초기화 오류는 별도 대표 글에서 다룹니다.
- 직접 확인
- ollama ps, nvidia-smi와 시스템 RAM을 같은 모델 실행 시점에 확인합니다.
- context 4096, parallel 1, loaded model 1에서 기준 실행을 재현합니다.
- 설정은 한 번에 하나만 바꾸고 동일 모델·프롬프트의 메모리와 성공 여부를 기록합니다.
Ollama 메모리 부족 오류는 모델 파일이 디스크에 내려받아졌다는 사실과 별개로, 실행 시 필요한 RAM·VRAM·K/V cache가 확보되지 않을 때 발생합니다. 큰 모델을 무작정 다시 받기보다 현재 로드된 모델을 내리고, context와 병렬 요청을 줄인 뒤 작은 양자화 모델로 기준선을 확인하는 편이 빠릅니다. 이 글은 Linux, Windows·WSL2와 Docker에서 모델 실행에 필요한 메모리 설정을 안전하게 조정하는 순서를 설명합니다.
ollama ps로 메모리에 남아 있는 모델과 PROCESSOR, CONTEXT를 확인하세요. 사용하지 않는 모델은 ollama stop 모델명으로 내리고, context 4K·병렬 요청 1개·동시 로드 모델 1개부터 다시 실행합니다. 이 상태에서 성공하면 드라이버보다 모델 크기나 실행 설정이 메모리 예산을 넘은 문제일 가능성이 큽니다.GPU 자체가 보이지 않거나 CUDA 초기화 오류가 반복되면 메모리 조정보다 GPU discovery를 먼저 해결해야 합니다. 해당 문제는 Ollama CUDA 오류 해결 가이드에서 다룹니다. 이 글은 GPU가 인식된 상태의 RAM·VRAM 부족, context, 동시 실행과 모델 상주 설정에 집중합니다.
로컬 API가 거부되면 Ollama Connection Refused 가이드, CLI·모델 이름·저장 위치가 맞지 않으면 설치 경로와 모델 설정 가이드를 먼저 확인하세요.
nvidia-smi가 실패하거나 CUDA 초기화 오류가 반복되면 CUDA·GPU 진단 가이드가 맞습니다.2026년 9월 24일 Ollama FAQ·Context length·API·Hardware support 문서와 Microsoft WSL 공식 문서를 대조했습니다. 특정 장비의 성공담이나 모든 모델에 통하는 고정 메모리 수치가 아니라, 같은 모델과 프롬프트로 변경 전후를 재현할 수 있는 측정 절차를 제공합니다.
Ollama 메모리 부족인지 5분 안에 확인하기
오류 메시지 하나만으로 RAM과 VRAM 중 어디가 부족한지 단정하기 어렵습니다. 모델을 실행한 직후 별도 터미널에서 아래 항목을 함께 확인하세요.
# Ollama에 로드된 모델, CPU·GPU 비율과 context 확인
ollama ps

# NVIDIA GPU의 VRAM과 실행 프로세스 확인
nvidia-smi

# Linux·WSL의 시스템 RAM 확인
free -h
Windows PowerShell에서는 시스템 메모리를 다음처럼 확인할 수 있습니다.
Get-CimInstance Win32_OperatingSystem |
  Select-Object TotalVisibleMemorySize, FreePhysicalMemory
Ollama 공식 FAQ에 따르면 ollama ps의 PROCESSOR가 100% GPU이면 모델 전체가 GPU에 올라간 상태입니다. CPU/GPU가 함께 표시되면 모델 일부가 시스템 메모리로 분산된 상태일 수 있으며, 이것만으로 오류라고 볼 수는 없습니다.
RAM, VRAM, context가 각각 하는 일
| 자원 | 주로 차지하는 항목 | 부족할 때 보이는 현상 |
|---|---|---|
| VRAM | GPU에 올라간 모델 가중치와 K/V cache | CPU/GPU 혼합 로드, GPU runner 종료, 할당 실패 |
| 시스템 RAM | CPU에 올라간 가중치, offload, Ollama와 운영체제 | 심한 swap, 프로세스 종료, 시스템 전체 멈춤 |
| context | 입력·출력 토큰과 대화 기록을 처리하는 메모리 | 긴 요청에서 메모리 급증, 속도 저하, 실행 실패 |
| 동시 요청 | 요청별 context와 K/V cache | 한 요청은 성공하지만 여러 요청에서 실패·대기 |
| 상주 모델 | 종료하지 않고 메모리에 유지된 모델 | 새 모델 로드 공간 부족, 예상보다 높은 유휴 메모리 |
모델 파일 크기만 보고 실행 메모리를 계산하면 오차가 큽니다. 가중치 외에도 context, cache, runtime overhead와 병렬 요청이 추가되기 때문입니다. 정확한 수치를 추측하기보다 작은 설정에서 실제 사용량을 측정한 뒤 한 항목씩 늘리세요.
증상별로 먼저 바꿀 설정
| 증상 | 가능성이 높은 원인 | 첫 조치 |
|---|---|---|
| 모델을 불러오자마자 종료 | 가중치가 RAM·VRAM 예산 초과 | 작은 양자화 모델로 비교 |
| 짧은 질문은 성공, 긴 문서에서 실패 | context와 K/V cache 증가 | num_ctx를 4096부터 재검증 |
| 한 명은 성공, 여러 요청에서 실패 | 병렬 요청이 메모리 증폭 | OLLAMA_NUM_PARALLEL=1 |
| 새 모델로 바꿀 때 실패 | 이전 모델이 계속 상주 | ollama stop 또는 keep_alive: 0 |
| WSL에서만 RAM 부족 | WSL2 VM의 memory 제한 | WSL 설정과 실제 가용 RAM 확인 |
nvidia-smi가 실패 | 메모리보다 드라이버·장치 문제 | CUDA·GPU 인식 진단으로 이동 |
가장 안전한 해결 순서 7단계
1. 사용하지 않는 모델부터 메모리에서 내리기
ollama ps
ollama stop your-model
Ollama는 모델을 기본적으로 일정 시간 메모리에 유지합니다. 방금 사용을 끝낸 모델이 다음 모델의 공간을 막는다면 먼저 명시적으로 내리세요. API에서는 keep_alive를 0으로 보내 응답 뒤 즉시 unload할 수 있습니다.
curl http://localhost:11434/api/generate -d '{
  "model": "your-model",
  "prompt": "메모리 확인",
  "keep_alive": 0
}'
2. 더 작은 양자화 모델로 기준선 만들기
같은 모델 계열이라도 parameter 수와 quantization에 따라 필요한 메모리가 달라집니다. 먼저 더 작은 parameter 수 또는 양자화된 variant로 실행을 확인하세요. 작은 모델은 성공하고 큰 모델만 실패한다면 설치 문제보다 메모리 예산 문제에 가깝습니다.
- 모델 이름과 정확한 variant를 기록합니다.
- 첫 테스트는 한 모델·한 요청·짧은 prompt로 고정합니다.
- 정확도가 중요한 작업은 양자화 수준을 바꿀 때 같은 평가 prompt로 품질을 비교합니다.
3. context 길이를 낮추기
Ollama의 context는 모델이 한 번에 사용할 수 있는 최대 token 수이며, 길수록 메모리 요구량이 커집니다. 현재 전용 문서는 VRAM에 따라 기본값이 달라질 수 있다고 안내하므로 모든 환경의 기본값을 하나로 가정하지 말고 ollama ps에서 실제 값을 확인하세요.
# 현재 terminal에서 서버를 직접 시작하는 예시
OLLAMA_CONTEXT_LENGTH=4096 ollama serve
API 요청별로는 options.num_ctx를 지정할 수 있습니다.
curl http://localhost:11434/api/generate -d '{
  "model": "your-model",
  "prompt": "짧은 기준 프롬프트",
  "options": { "num_ctx": 4096 }
}'
4K에서 성공했다고 바로 큰 값으로 올리지 말고 8K, 16K처럼 단계적으로 높이면서 동일한 workload의 메모리와 응답 결과를 기록합니다.
4. 병렬 요청과 동시 로드 모델을 1개로 제한하기
Ollama FAQ는 병렬 처리 시 필요한 RAM이 대략 OLLAMA_NUM_PARALLEL × OLLAMA_CONTEXT_LENGTH에 비례해 증가한다고 설명합니다. 메모리 부족을 복구하는 동안은 병렬 요청과 로드 모델 수를 모두 1로 두세요.
OLLAMA_NUM_PARALLEL=1 \
OLLAMA_MAX_LOADED_MODELS=1 \
OLLAMA_CONTEXT_LENGTH=4096 \
ollama serve
한 요청이 안정적으로 끝난 뒤 실제 동시 사용자 수에 맞춰 하나씩 늘립니다. queue만 키우면 메모리 요구량이 줄어드는 것이 아니므로 원인 해결로 착각하지 마세요.
5. 모델 상주 시간을 짧게 조정하기
모델을 오래 유지하면 다음 요청은 빨라질 수 있지만 여러 모델을 번갈아 쓸 때 메모리 회수가 늦어집니다. 개발 PC처럼 메모리가 빠듯한 환경에서는 짧은 상주 시간부터 시작할 수 있습니다.
OLLAMA_KEEP_ALIVE=2m ollama serveAPI의 keep_alive에는 기간을 지정할 수 있고, 0은 응답 후 즉시 unload, 음수는 계속 상주를 의미합니다. 메모리 부족을 해결하려는 동안 무기한 상주 값은 피하세요.
6. Flash Attention과 K/V cache 양자화 검토하기
공식 FAQ에 따르면 Flash Attention은 context가 커질수록 메모리 사용을 크게 줄일 수 있습니다. 지원 환경이라면 다음 설정을 시험할 수 있습니다.
OLLAMA_FLASH_ATTENTION=1 \
OLLAMA_KV_CACHE_TYPE=q8_0 \
ollama serve
q8_0 K/V cache는 기본 f16 대비 대략 절반의 메모리를 사용하며 정밀도 손실이 매우 작다고 Ollama는 설명합니다. q4_0은 대략 4분의 1 수준이지만 품질 영향이 더 클 수 있습니다. 먼저 q8_0으로 같은 prompt의 정확도와 안정성을 검증하세요. 이 설정은 Flash Attention과 함께 사용하는 조건을 공식 문서에서 확인해야 합니다.
7. WSL2와 container의 메모리 제한 확인하기
Windows 전체 RAM이 충분해도 WSL2 VM에 낮은 제한이 설정돼 있으면 Linux 안의 Ollama가 메모리를 사용할 수 없습니다. Microsoft 문서에 따르면 %UserProfile%\.wslconfig의 memory는 WSL2 VM에 할당할 메모리를 정하며 기본값은 Windows 전체 메모리의 50%입니다.
# %UserProfile%\.wslconfig 예시
[wsl2]
memory=16GB
swap=8GB
숫자를 그대로 복사하지 말고 Windows와 다른 앱에 남길 여유를 고려해 장비에 맞게 정하세요. 변경 후에는 PowerShell에서 wsl --shutdown을 실행하고 WSL을 다시 시작해야 적용됩니다. Docker를 사용한다면 container memory limit과 Docker Desktop의 Resource 설정도 별도로 확인합니다. swap은 갑작스러운 종료를 완화할 수 있지만 VRAM을 대체하지 않으며 응답 속도가 크게 느려질 수 있습니다.
Linux systemd에서 Ollama 메모리 설정하기
터미널 앞에 붙인 환경 변수는 systemd로 실행 중인 Ollama 서비스에 전달되지 않습니다. 서비스 환경을 바꾸려면 override를 사용합니다.
sudo systemctl edit ollama[Service]
Environment="OLLAMA_CONTEXT_LENGTH=4096"
Environment="OLLAMA_NUM_PARALLEL=1"
Environment="OLLAMA_MAX_LOADED_MODELS=1"
Environment="OLLAMA_KEEP_ALIVE=2m"
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KV_CACHE_TYPE=q8_0"sudo systemctl daemon-reload
sudo systemctl restart ollama
sudo systemctl show ollama --property=Environment
sudo journalctl -u ollama --no-pager -n 100복구 테스트에서는 최소 설정만 적용하고, 변경 전 값을 따로 기록하세요. 안정화 뒤 context나 parallel을 올릴 때도 한 번에 하나만 변경해야 원인을 추적할 수 있습니다.
Windows와 macOS에서 환경 변수 적용하기
Windows 앱은 사용자 환경 변수를 추가한 뒤 작업 표시줄의 Ollama를 완전히 종료하고 다시 시작해야 합니다. PowerShell session에서만 설정한 값은 tray 앱에 적용되지 않을 수 있습니다.
# PowerShell에서 현재 session 테스트
$env:OLLAMA_CONTEXT_LENGTH="4096"
$env:OLLAMA_NUM_PARALLEL="1"
$env:OLLAMA_MAX_LOADED_MODELS="1"
ollama serve
macOS 앱도 launchctl setenv로 환경을 지정한 뒤 Ollama 앱을 재시작합니다. 적용 여부는 실제 모델을 실행한 상태에서 ollama ps로 확인하세요.
Docker에서 메모리 절약 설정하기
기존 volume과 container 이름을 확인한 뒤 환경 변수를 포함해 실행합니다. 다음 예시는 GPU 전달이 이미 정상인 NVIDIA 환경을 가정합니다.
docker run -d --gpus=all \
  -v ollama:/root/.ollama \
  -p 11434:11434 \
  -e OLLAMA_CONTEXT_LENGTH=4096 \
  -e OLLAMA_NUM_PARALLEL=1 \
  -e OLLAMA_MAX_LOADED_MODELS=1 \
  -e OLLAMA_KEEP_ALIVE=2m \
  --name ollama \
  ollama/ollama
container에 RAM 상한을 설정했다면 호스트에 메모리가 남아 있어도 Ollama가 종료될 수 있습니다. docker inspect ollama와 docker stats ollama로 제한과 실사용량을 함께 확인하세요. 기존 container를 교체할 때 named volume을 삭제하지 않아야 내려받은 모델을 보존할 수 있습니다.
설정 변경 후 재현 테스트하는 방법
- 다른 모델을 모두 내리고 기준 모델 하나만 선택합니다.
- context 4096, parallel 1, loaded model 1로 시작합니다.
- 실행 직전 RAM·VRAM을 기록합니다.
- 같은 prompt를 실행하고
ollama ps의PROCESSOR와CONTEXT를 기록합니다. - 실행 후 RAM·VRAM과 성공 여부, 로그의 오류 시각을 기록합니다.
- context나 병렬 요청 중 하나만 늘려 다시 비교합니다.
| 기록 항목 | 예시 | 판단에 쓰는 이유 |
|---|---|---|
| 모델·quantization | 정확한 tag | 가중치 크기 차이 구분 |
| context | 4096 | K/V cache 증가 비교 |
| parallel·loaded models | 1·1 | 동시 실행 영향 분리 |
| PROCESSOR | 100% GPU 또는 혼합 | 실제 배치 위치 확인 |
| RAM·VRAM 전후 | GiB 단위 | 여유량과 증가폭 확인 |
| 결과·로그 | 성공 또는 오류 원문 | 변경 효과 재현 |
자주 하는 실수
- 모델 파일이 디스크에 들어간다는 이유로 RAM·VRAM에도 들어간다고 가정하지 않습니다.
- 메모리가 부족한데 context와 parallel을 동시에 올리지 않습니다.
- 이전 모델이 상주한 상태에서 새 모델만 반복 실행하지 않습니다.
- CPU/GPU 혼합 표시를 곧바로 GPU 고장으로 판단하지 않습니다.
- swap을 늘리는 것을 VRAM 확보와 같은 해결책으로 보지 않습니다.
- K/V cache를
q4_0로 바꾼 뒤 품질 검증을 생략하지 않습니다. - WSL의 memory 값을 Windows 전체 RAM과 같게 잡아 호스트의 여유를 없애지 않습니다.
최종 체크리스트
사용하지 않는 모델이 내려갔다. 작은 모델·context 4096·parallel 1에서 같은 prompt가 완료된다.
ollama ps에 예상한 context와 PROCESSOR가 표시된다. RAM과 VRAM에 운영체제용 여유가 남는다. context와 동시 요청을 하나씩 늘려 실패 임계점을 기록했다. WSL·Docker의 별도 memory limit을 확인했다. 변경 후 로그에 반복되는 out-of-memory 또는 runner 종료가 없다.편집부 결론
Ollama 메모리 부족은 RAM 용량 하나만의 문제가 아닙니다. 모델 가중치, context, K/V cache, 병렬 요청과 상주 모델이 같은 예산을 나눠 쓰기 때문에 각각을 분리해야 합니다. 가장 재현성 높은 출발점은 작은 양자화 모델, context 4096, parallel 1, loaded model 1입니다.
이 기준선에서 성공한 뒤 필요한 항목만 단계적으로 높이면 장비를 교체해야 하는지, 설정만 줄이면 되는지 판단할 수 있습니다. 반대로 nvidia-smi 자체가 실패하거나 작은 모델도 CUDA 초기화 단계에서 종료된다면 메모리 설정을 반복하지 말고 드라이버와 GPU 인식 경로를 진단하세요.
공식 문서와 함께 읽을 글
Ollama FAQ에서 메모리·병렬 처리 설정 확인하기
Ollama Context length 공식 설명 보기
자주 묻는 질문
Ollama 모델 실행에 RAM과 VRAM이 얼마나 필요한가요?
모델 parameter, quantization, context, 병렬 요청과 CPU·GPU 배치에 따라 달라 고정값으로 답하기 어렵습니다. 모델 파일 크기만 보지 말고 작은 context·요청 1개에서 ollama ps, RAM과 VRAM 증가량을 직접 기록하세요.
모델 다운로드는 끝났는데 왜 메모리 부족 오류가 나나요?
다운로드에는 디스크 공간이 필요하지만 추론에는 RAM·VRAM과 cache 공간이 추가로 필요합니다. 디스크 여유와 실행 메모리는 별개의 조건입니다.
ollama ps에 CPU와 GPU가 함께 표시되면 실패인가요?
아닙니다. 모델 일부가 GPU에, 나머지가 시스템 메모리에 배치된 상태일 수 있습니다. 응답이 정상 완료되는지와 RAM·VRAM 여유, 실제 속도를 함께 판단하세요.
context를 줄이면 답변 품질이 떨어지나요?
모델이 한 번에 참고할 수 있는 대화와 문서 길이가 줄어듭니다. 현재 작업에 필요한 범위보다 지나치게 작으면 정보가 잘릴 수 있으므로 4K에서 복구를 확인한 뒤 실제 문서 길이에 맞춰 단계적으로 늘리세요.
OLLAMA_NUM_PARALLEL=1은 꼭 유지해야 하나요?
복구를 확인할 때의 안전한 기준값입니다. 안정화 뒤 실제 동시 요청을 재현하면서 2, 3처럼 단계적으로 늘리고 각 단계의 메모리와 실패 여부를 기록하면 됩니다.
keep_alive: 0은 무엇을 하나요?
해당 API 응답이 끝난 뒤 모델을 즉시 메모리에서 내립니다. 다음 요청의 재로딩 시간은 늘지만 여러 모델을 번갈아 쓰는 저메모리 환경에서는 공간 회수에 유용합니다.
K/V cache를 q8_0로 바꿔도 안전한가요?
공식 문서는 f16 대비 메모리를 대략 절반으로 줄이고 정밀도 손실이 매우 작다고 설명합니다. 그래도 작업과 모델마다 영향이 다를 수 있으므로 같은 평가 prompt로 결과를 비교해야 합니다.
WSL에서 RAM을 늘리면 VRAM 부족도 해결되나요?
아닙니다. WSL의 memory는 VM이 사용할 시스템 RAM을 조정합니다. CPU offload 공간에는 도움이 될 수 있지만 GPU VRAM 자체를 늘리지는 않습니다.
RAM을 추가할지 GPU를 바꿀지 어떻게 판단하나요?
ollama ps, nvidia-smi와 시스템 RAM을 같은 실행에서 기록하세요. VRAM만 가득 차고 RAM에 여유가 있다면 작은 모델·context 또는 더 큰 VRAM을 검토하고, CPU offload로 RAM까지 소진되면 시스템 RAM과 workload를 함께 재평가합니다.
Evidence & Limitations
근거·검증 범위·업데이트 기록
확인한 근거
Ollama FAQ 공식 문서를 기준으로 핵심 사실을 확인하고, 사실과 편집부 해석을 구분했습니다.
경험 정보와 한계
직접 사용 후기나 자체 성능 시험이 아닌 공개 원문·공식 문서 기반 분석입니다. 실제 화면과 기능은 계정·기기·배포 시점에 따라 다를 수 있습니다.
게시·수정 기록
최초 게시 2026.09.24 11:45 · 최종 수정 2026. 09. 24.
전문 검토 영역
IT 매거진 편집부가 AI·소프트웨어·개발·모바일·보안·테크 비즈니스 관점에서 구성하고 팩트체크 데스크가 출처와 표현을 검토했습니다.
Related Articles
이 주제를 더 깊게 읽어보세요
현재 기사와 연결되는 배경·기술·시장 분석을 골라 바로 이동할 수 있습니다.