AI 코딩 에이전트 테스트 자동화: 코드 검증과 오류 탐지 방법
Quick Answer
먼저 보는 핵심 답변
AI 코딩 에이전트로 실패 재현 테스트를 만들고 lint·타입 검사·단위·통합·E2E 테스트와 빌드를 실행해 코드 오류와 회귀를 검증하는 방법입니다. 프론트엔드·백엔드·Java 명령, CI 품질 게이트, Playwright trace와 결과 보고서까지 정리했습니다.
Search Intent
이 글에서 해결할 문제
- 이런 분께
- 특정 CI 서비스보다 먼저 AI 코딩 에이전트가 만든 변경을 어떤 테스트 계층과 판정 기준으로 검증할지 정하려는 개발자
- 읽고 나면
- 실패 재현부터 lint·타입·단위·통합·E2E·빌드까지 위험도에 맞는 검증 순서를 설계할 수 있습니다.
- 다루는 범위
- GitHub Actions YAML 작성법은 별도 연동 글에서 다루며, 이 글은 도구와 무관한 테스트 전략·오류 증거·품질 게이트에 집중합니다.
- 직접 확인
- 수정 전 실패하고 수정 후 통과하는 재현 테스트를 남깁니다.
- lint·타입·단위·통합·E2E·빌드의 종료 코드를 기록합니다.
- 브라우저 오류는 screenshot·video·trace 같은 증거로 보존합니다.
AI 코딩 에이전트 테스트 자동화는 에이전트가 코드를 수정한 뒤 lint·타입 검사·단위 테스트·통합 테스트·브라우저 테스트를 정해진 순서로 실행하고, 실패 로그를 근거로 원인을 좁힌 다음 회귀 테스트로 수정 결과를 다시 확인하는 방법입니다. 핵심은 에이전트의 “완료했습니다”라는 설명이 아니라 같은 명령을 사람이 다시 실행해도 통과하는 코드, 테스트 결과와 실패 증거를 남기는 데 있습니다.
기존 테스트가 통과하는 기준 상태를 먼저 기록하고 문제를 재현하는 가장 작은 실패 테스트를 만드세요. 그다음 최소 범위의 코드를 수정해 관련 테스트를 통과시키고, 마지막에 전체 회귀 테스트·빌드·정적 분석을 다시 실행합니다. 실패 시에는 명령, 종료 코드, 실패한 테스트 이름, 예상값과 실제값, 로그·스크린샷·트레이스를 남겨야 AI의 추측과 실제 오류를 구분할 수 있습니다.
이 글은 2026년 9월 9일 Playwright, GitHub Actions와 OWASP의 공식 문서를 대조해 작성한 실무 가이드입니다. 특정 AI 코딩 도구가 모든 결함을 탐지한다는 성능 시험이나 유료 제품 사용 후기가 아닙니다. 예시 명령은 프로젝트의
package.json, 빌드 도구와 테스트 프레임워크에 맞게 바꿔야 합니다.AI 코딩 에이전트 테스트 자동화란
AI 코딩 에이전트는 저장소를 읽고 파일을 수정하며 터미널 명령을 실행할 수 있습니다. 이 능력을 테스트에 연결하면 실패 원인 후보를 찾고, 재현 테스트를 추가하고, 수정 후 검증 결과를 요약하는 반복 작업을 줄일 수 있습니다.
그러나 언어 모델의 판단 자체는 테스트 결과가 아닙니다. 테스트 명령이 실행되지 않았거나 실패를 건너뛰었는데도 코드를 보고 통과할 것이라고 예상할 수 있습니다. 따라서 에이전트는 테스트를 작성하고 실행하는 작업자로 사용하고, 최종 판정은 프로세스의 종료 코드·assertion·빌드 결과와 사람이 확인할 수 있는 artifact에 맡겨야 합니다.
코드리뷰 자동화와 다른 점
| 구분 | 주요 입력 | 결과 | 한계 |
|---|---|---|---|
| AI 코드리뷰 | diff, 요구사항, 프로젝트 규칙 | 문제 후보와 수정 제안 | 실행하지 않은 경로는 가설일 수 있음 |
| 정적 분석 | 소스 코드와 규칙 | 타입·패턴·보안 경고 | 실제 런타임 상태를 모두 확인하지 못함 |
| 자동 테스트 | 실행 코드, 입력, 기대 결과 | 재현 가능한 통과·실패 | 작성된 시나리오 밖의 결함은 놓침 |
| AI 테스트 자동화 | 요구사항, 코드, 기존 테스트, 실행 로그 | 테스트 생성·실행·오류 분석·수정 반복 | 잘못된 기대값과 취약한 테스트를 만들 수 있음 |
실무에서는 네 방법을 경쟁 관계로 보지 않는 편이 좋습니다. formatter와 타입 검사로 확정적인 문제를 먼저 제거하고, AI가 테스트 공백과 실패 원인을 찾게 하며, CI와 사람이 결과를 최종 검토하는 구조가 안정적입니다.
자동화 전에 통과 기준부터 정하기
“테스트해줘”만 요청하면 에이전트가 빠른 테스트 몇 개만 실행하고 완료로 판단할 수 있습니다. 프로젝트에 맞는 품질 게이트를 명시하세요.
| 단계 | 찾는 문제 | 통과 기준 예시 |
|---|---|---|
| Format·Lint | 문법, 미사용 코드, 위험한 패턴 | 오류 0건, 경고 허용 기준 충족 |
| Type check·Compile | 타입과 인터페이스 불일치 | 종료 코드 0 |
| Unit test | 함수와 클래스의 정상·경계·실패 조건 | 관련 테스트 전부 통과 |
| Integration·API test | DB, API, 모듈 사이 계약 | 격리된 테스트 데이터로 전부 통과 |
| End-to-end test | 사용자에게 보이는 핵심 흐름 | 주요 브라우저·환경 기준 충족 |
| Security scan | 취약 패턴·dependency·secret 노출 | 팀이 정한 차단 등급 0건 |
| Production build | 번들·컴파일·배포 구성 오류 | 실제 배포 명령 성공 |
coverage 숫자 하나만 통과 기준으로 쓰면 의미 없는 assertion을 늘릴 수 있습니다. 중요한 비즈니스 규칙과 실패 경로가 검증되는지, 변경된 분기가 테스트와 연결되는지를 함께 확인해야 합니다.
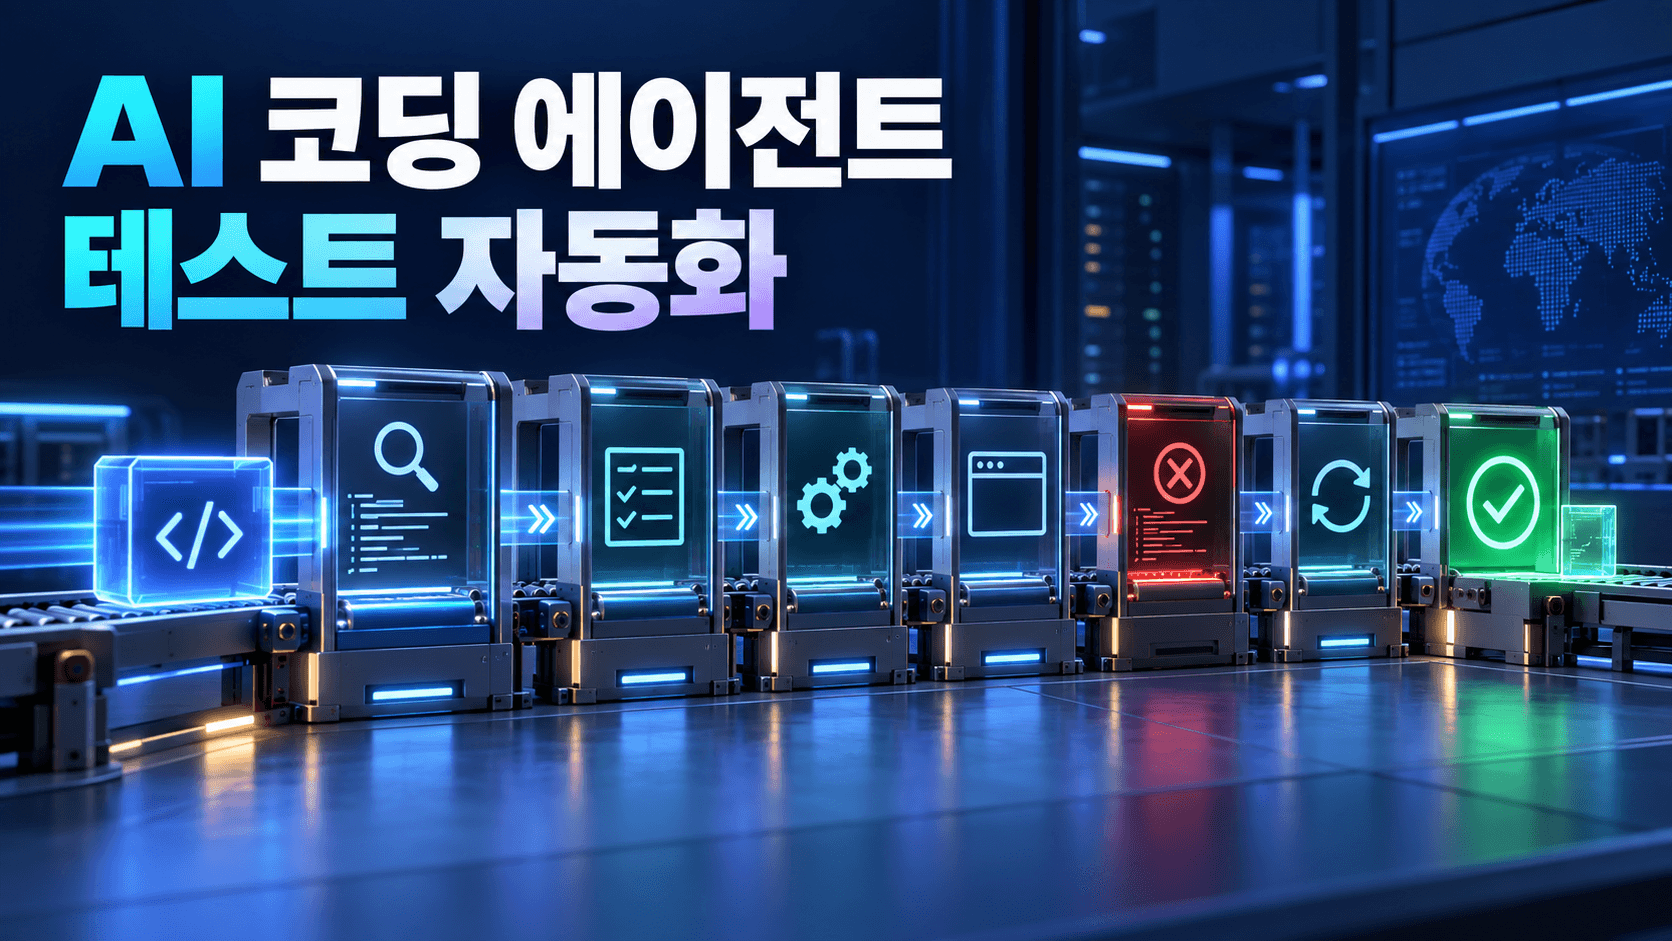
가장 안전한 8단계 테스트 자동화 흐름
- 범위를 고정합니다. 요구사항, 변경 파일, 금지된 파일과 실행 가능한 명령을 정합니다.
- 기준 상태를 확인합니다. 코드를 바꾸기 전에 기존 테스트를 실행해 원래 실패와 새 회귀를 구분합니다.
- 실패를 재현합니다. 버그라면 수정 전에 같은 오류가 나는 최소 테스트를 추가합니다.
- 원인을 좁힙니다. stack trace, 로그와 관련 호출 경로를 근거로 가설을 세웁니다.
- 최소 수정합니다. 관계없는 리팩터링과 dependency 변경을 분리합니다.
- 표적 테스트를 실행합니다. 수정한 함수나 기능과 직접 관련된 테스트를 빠르게 돌립니다.
- 전체 회귀 검증을 합니다. lint, 타입, 전체 테스트, 빌드와 필요한 보안 검사를 새 환경에서 실행합니다.
- 증거를 보고합니다. 실행 명령, 결과, 남은 위험과 실행하지 못한 항목을 구분합니다.
에이전트에 전달할 범용 요청문
“이 저장소에서 [변경 목적 또는 오류 증상]을 검증해줘. 먼저 프로젝트 문서와 package/build 설정에서 공식 테스트 명령을 찾아 목록으로 보여줘. 코드를 수정하기 전에 현재 상태의 lint, 타입 검사와 관련 테스트를 실행해 기준 결과를 기록해. 버그라면 실패를 재현하는 가장 작은 테스트를 먼저 추가하고, 그 테스트가 수정 전 실패하는지 확인해.
원인을 로그와 호출 경로로 설명한 뒤 최소 범위만 수정해. 관련 테스트가 통과하면 전체 테스트와 production build를 실행해 회귀를 확인해. 테스트를 삭제하거나 assertion을 약하게 만들거나 실패를 skip해서 통과시키지 마. 실행하지 못한 명령은 통과로 표시하지 말고 이유와 필요한 조건을 적어줘.
최종 결과는 변경 파일 → 재현 테스트 → 실행 명령과 종료 코드 → 통과·실패 건수 → 남은 위험 → 사람이 확인할 항목 순서로 보고해줘. 비밀정보, 운영 데이터, 외부 서비스 변경과 배포는 내 승인 없이 사용하거나 실행하지 마.”
실패 재현 테스트가 먼저인 이유
오류를 재현하지 않고 구현부터 바꾸면 우연히 증상이 사라진 것인지 실제 원인이 해결된 것인지 판단하기 어렵습니다. 수정 전에는 실패하고 수정 후에는 통과하는 테스트가 남아야 같은 문제가 다시 들어왔을 때 CI가 막을 수 있습니다.
- 버그를 일으키는 최소 입력과 사전 상태를 기록합니다.
- 기대한 결과와 실제 결과를 assertion으로 분리합니다.
- 현재 시각, 네트워크와 실행 순서 같은 비결정 요소를 고정합니다.
- 내부 함수 구현보다 사용자가 관찰하는 결과나 공개 계약을 검증합니다.
- 수정 후에도 테스트를 유지해 회귀 방지 역할을 하게 합니다.
프론트엔드와 React 프로젝트 검증 순서
React와 웹 프론트엔드는 정적 검사만 통과해도 브라우저에서 hydration, 라우팅, 입력과 접근성 문제가 남을 수 있습니다. 다음 순서를 프로젝트 스크립트에 맞춰 적용하세요.
pnpm install --frozen-lockfile
pnpm run lint
pnpm run typecheck
pnpm run test
pnpm run build
pnpm exec playwright testtypecheck나 Playwright 스크립트가 없는 프로젝트에 명령을 억지로 추가하지 마세요. 먼저 package.json과 CI workflow에서 팀이 실제로 사용하는 명령을 확인해야 합니다.
브라우저 테스트는 CSS class 같은 구현 세부보다 버튼 이름, label, role과 화면에 보이는 결과를 기준으로 작성하는 편이 변경에 강합니다. Playwright 공식 모범 사례도 사용자에게 보이는 동작, 테스트 격리, user-facing locator와 자동 재시도 assertion을 권장합니다.
백엔드·API 프로젝트 검증 순서
백엔드 테스트는 정상 응답만 확인해서는 부족합니다. 인증과 권한, 입력 검증, transaction rollback, 중복 요청, timeout과 외부 서비스 실패를 함께 다뤄야 합니다.
- 각 테스트가 독립된 DB 또는 transaction을 사용하게 합니다.
- 외부 API는 계약을 명시한 mock·stub 또는 격리된 sandbox로 대체합니다.
- 같은 요청을 두 번 보내도 중복 결제·생성이 일어나지 않는지 확인합니다.
- 401과 403, 빈 값과 잘못된 형식, 최대 크기 입력을 구분합니다.
- 오류 응답과 로그에 token, 개인정보와 stack trace가 노출되지 않는지 봅니다.
- schema migration은 기존 데이터와 rollback 가능성을 별도 환경에서 검증합니다.
Java 프로젝트에서 적용하는 방법
Java 프로젝트는 Maven 또는 Gradle wrapper를 우선 사용하면 개발자 PC와 CI의 도구 버전을 맞추기 쉽습니다.
# Maven Wrapper 예시
./mvnw test
./mvnw verify

# Gradle Wrapper 예시
./gradlew test
./gradlew check
./gradlew build
에이전트에는 단위 테스트와 통합 테스트가 어느 task/profile에 포함되는지 먼저 확인하게 하세요. test만 실행하고 integration test나 정적 분석이 빠졌는데 전체 검증이 끝났다고 보고하지 않도록 실제 CI 명령과 완료 조건을 명시해야 합니다.
브라우저 오류는 Trace로 남기기
CI에서만 나타나는 웹 테스트 실패는 마지막 스크린샷만으로 원인을 찾기 어렵습니다. Playwright Trace Viewer는 action, DOM snapshot, source, console과 network 기록을 한 흐름에서 확인할 수 있습니다. 공식 문서는 CI에서 첫 retry에 trace를 기록하는 설정을 안내하며 모든 성공 테스트에서 항상 기록하는 방식은 비용이 커질 수 있다고 설명합니다.
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: process.env.CI ? 1 : 0,
  use: {
    screenshot: 'only-on-failure',
    trace: 'on-first-retry',
  },
});
retry 후 통과했다면 무조건 성공으로 끝내지 말고 flaky 후보로 표시하세요. 재시도가 실제 결함을 숨기는 장치가 되지 않도록 첫 실패의 trace와 빈도를 함께 보관해야 합니다.
GitHub Actions에서 품질 게이트 만들기
로컬에서 에이전트가 실행한 결과만 믿지 말고 깨끗한 CI runner에서 같은 검사를 다시 실행하세요. GitHub의 Node.js CI 공식 문서는 setup-node로 Node 버전을 지정하고 dependency 설치, build와 test를 workflow에 넣는 구조를 안내합니다.
name: verify

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v6
      - uses: pnpm/action-setup@v4
      - uses: actions/setup-node@v7
        with:
          node-version: 22
          cache: pnpm
      - run: pnpm install --frozen-lockfile
      - run: pnpm run lint
      - run: pnpm run test
      - run: pnpm run build
      - name: Upload failure evidence
        if: failure()
        uses: actions/upload-artifact@v6
        with:
          name: test-results
          path: test-results/
Action 버전과 Node 버전은 예시입니다. 적용 시 각 Action의 공식 릴리스와 저장소 지원 버전을 확인하고, 조직 정책에 따라 commit SHA 고정을 검토하세요. 저장소에 존재하지 않는 test 스크립트를 그대로 복사하지 말고 실제 명령으로 바꿉니다.
AI가 테스트를 속이지 못하게 하는 규칙
- 실패 테스트를 삭제하거나
skip,only로 바꾸지 않습니다. - 기대값을 현재의 잘못된 출력에 맞춰 수정하지 않습니다.
- timeout을 무작정 늘리거나 재시도 횟수로 실패를 숨기지 않습니다.
- coverage 제외 주석과 lint disable을 추가하려면 이유와 승인을 요구합니다.
- mock이 테스트 대상 자체를 대신하지 않게 호출 경계를 확인합니다.
- 명령의 일부만 실행했으면 전체 통과라고 표현하지 않습니다.
- test와 build의 종료 코드를 그대로 보존합니다.
- 변경 전·후 결과를 같은 환경과 명령으로 비교합니다.
Flaky test와 실제 버그 구분하기
같은 commit에서 결과가 바뀌면 시간, 무작위 값, 공유 상태, 네트워크, 순서 의존성과 자원 부족을 의심해야 합니다. 실패를 없애기 위해 retry만 추가하기보다 다음 정보를 수집하세요.
- 실패한 commit SHA, OS, 런타임과 브라우저 버전을 기록합니다.
- 실패 테스트 하나를 동일 seed와 동일 데이터로 반복 실행합니다.
- 단독 실행과 전체 suite 실행 결과를 비교합니다.
- 병렬 실행을 끈 결과로 공유 상태와 race 가능성을 확인합니다.
- 시간과 외부 응답을 고정하고 trace·console·network 로그를 봅니다.
- 원인을 고친 뒤 임시 retry를 제거할 수 있는지 확인합니다.
정적 분석과 보안 검사를 함께 연결하기
기능 테스트가 통과해도 injection, 권한 누락과 dependency 취약점이 남을 수 있습니다. SAST, dependency scan, secret scan과 OWASP 기반의 위험 시나리오를 별도 품질 게이트로 운영하세요. OWASP WSTG는 웹 애플리케이션과 서비스의 보안 통제를 체계적으로 검증하는 방법을 제공하지만, 모든 프로젝트에 똑같은 체크리스트를 기계적으로 적용하기보다 위협 모델과 위험도에 맞춰 범위를 정해야 합니다.
AI가 보안 테스트 payload를 만들거나 실행할 때는 소유하거나 명시적으로 허가받은 격리 환경만 사용해야 합니다. 운영 시스템, 제3자 서비스와 실제 고객 데이터에 능동 테스트를 실행하지 않도록 대상 domain·계정·네트워크 권한을 제한하세요.
권한과 비밀정보를 보호하는 방법
- 기본은 저장소 읽기와 테스트 실행만 허용하고 배포·merge 권한을 분리합니다.
- 운영 API key 대신 테스트 전용 최소 권한 credential을 사용합니다.
- 명령 실행 전 허용된 디렉터리와 금지 명령을 규칙으로 둡니다.
- 로그, screenshot과 trace에 token·쿠키·개인정보가 들어갈 수 있음을 고려합니다.
- artifact 접근 권한과 보존 기간을 정하고 필요한 사람만 내려받게 합니다.
- dependency 설치 script와 외부 Action을 신뢰하기 전에 출처와 권한을 검토합니다.
- 삭제, migration, 결제, 게시와 배포는 사람 승인 뒤 별도 단계에서 실행합니다.
테스트 결과 보고서 템플릿
변경 목적: [한 문장]
기준 commit: [SHA]
변경 파일: [목록]
재현 조건: [입력·상태·실행 순서]
수정 전 결과: [실패 테스트·오류 메시지]
원인: [코드와 로그 근거]
수정 내용: [최소 변경 요약]
실행 명령: [명령별 종료 코드]
최종 결과: lint [통과/실패], type [통과/실패], unit [통과 수/실패 수], integration [결과], E2E [결과], build [결과]
증거: [CI run·report·trace 경로]
실행하지 못한 항목: [항목과 이유]
남은 위험: [사람이 확인할 내용]
실무에서 자주 발생하는 실패와 해결법
로컬에서는 통과하지만 CI에서 실패합니다
런타임, lockfile, OS, 환경 변수와 시간대를 비교하세요. 설치 명령이 lockfile을 고정하는지 확인하고 DB·브라우저·시스템 dependency 버전을 명시합니다. 실패 artifact와 workflow 로그를 내려받아 같은 commit을 기준으로 재현합니다.
AI가 새 테스트를 만들었는데 항상 통과합니다
테스트가 실제 변경 코드를 호출하는지, assertion이 결과를 검증하는지 확인합니다. 의도적으로 구현을 원래 오류 상태로 되돌렸을 때 테스트가 실패하는 mutation check를 해보면 무효 테스트를 찾는 데 도움이 됩니다.
전체 테스트 시간이 너무 깁니다
개발 중에는 변경 파일과 관련된 표적 테스트를 먼저 실행하고, PR CI에서는 전체 회귀 검증을 유지합니다. 독립 테스트를 병렬화하고 dependency cache를 사용하되, 테스트 순서 의존성과 공유 DB 충돌이 없는지 먼저 확인하세요.
오류가 고쳐질 때마다 다른 테스트가 깨집니다
공유 fixture, 전역 상태, transaction 정리와 test double의 범위를 점검하세요. 한 테스트가 만든 상태를 다음 테스트가 기대한다면 격리가 깨진 것입니다. 독립 실행과 무작위 순서 실행을 비교해 의존성을 찾습니다.
도입 전 최종 체크리스트
프로젝트의 실제 검사 명령을 확인했다. 변경 전 기준 결과가 있다. 버그를 재현하는 테스트가 수정 전 실패했다. 테스트 삭제·skip·약한 assertion이 없다. 관련 테스트와 전체 suite를 구분해 실행했다. production build가 통과했다. 실패 로그·trace·screenshot을 보존했다. 실행하지 못한 항목을 통과로 쓰지 않았다. 비밀정보와 운영 데이터가 없다. 배포·merge 같은 되돌리기 어려운 작업은 사람이 승인한다.
편집부 결론
AI 코딩 에이전트 테스트 자동화의 품질은 생성한 테스트 수가 아니라 오류를 재현하고, 수정이 원인을 해결했음을 증명하며, 기존 기능의 회귀까지 잡을 수 있는지로 판단해야 합니다. 가장 실용적인 구조는 “기준 상태 → 실패 재현 → 최소 수정 → 표적 테스트 → 전체 회귀 테스트 → 깨끗한 CI 재검증 → 증거 보고”입니다.
에이전트가 모든 검사를 대신한다고 생각하기보다 반복 실행과 분석을 맡기고, 제품 요구사항·보안 위험·운영 영향의 최종 판단은 개발자와 담당자가 유지하세요. 도구와 버전이 바뀌어도 재현 가능한 명령, 명시적인 기대 결과와 최소 권한이라는 원칙은 오래 사용할 수 있습니다.
공식 문서와 함께 읽을 글
Playwright 테스트 격리·Locator 모범 사례 확인하기
Playwright Trace Viewer로 CI 실패 분석하기
GitHub Actions Node.js 빌드·테스트 공식 가이드
Claude Code Hooks로 검사 명령 자동화하기
자주 묻는 질문
AI 코딩 에이전트가 테스트를 모두 통과하면 안전한 코드인가요?
그렇지 않습니다. 작성된 테스트가 다루는 범위 안에서 기대 결과와 일치했다는 뜻입니다. 요구사항 누락, 운영 환경 차이, 보안과 성능 문제는 별도 검증과 사람 리뷰가 필요합니다.
AI가 만든 테스트 코드를 그대로 사용해도 되나요?
테스트가 실제 대상 코드를 호출하는지, assertion이 요구사항을 검증하는지, mock이 지나치지 않은지 리뷰해야 합니다. 구현을 일부러 깨뜨렸을 때 실패하는지도 확인하세요.
수정 전 실패 테스트를 꼭 만들어야 하나요?
재현 가능한 버그라면 권장합니다. 수정 전 실패와 수정 후 통과가 확인돼야 원인을 실제로 해결했는지 판단하고 같은 회귀를 다시 막을 수 있습니다.
단위 테스트와 E2E 테스트 중 무엇을 먼저 실행하나요?
개발 중에는 빠른 lint·타입 검사와 관련 단위 테스트를 먼저 실행합니다. 통과 후 통합·E2E·빌드를 포함한 전체 회귀 검증을 CI에서 실행하는 방식이 효율적입니다.
Retry 후 통과한 테스트는 성공인가요?
빌드 정책상 성공으로 처리할 수 있어도 flaky 후보로 별도 기록해야 합니다. 첫 실패의 trace와 로그를 보존하고 시간·공유 상태·네트워크·실행 순서 의존성을 조사하세요.
테스트 coverage는 몇 퍼센트가 적당한가요?
모든 프로젝트에 맞는 단일 숫자는 없습니다. 팀의 위험도에 따라 기준을 정하되 줄 수보다 핵심 비즈니스 규칙, 경계 조건, 오류·권한 경로가 실제로 검증되는지를 우선하세요.
CI에서 어떤 증거를 남겨야 하나요?
commit SHA, 실행 환경, 명령과 종료 코드, 테스트 report, 실패 로그를 남기세요. 브라우저 실패에는 screenshot과 trace, 시각 회귀에는 expected·actual·diff 이미지를 보관하면 재현에 도움이 됩니다.
AI 에이전트에 운영 시스템 테스트를 맡겨도 되나요?
권장하지 않습니다. 테스트 전용 계정과 격리 환경을 사용하고 대상 domain과 권한을 제한하세요. 운영 데이터 변경, 보안 능동 테스트, 결제, 삭제와 배포는 명시적 승인과 별도 절차가 필요합니다.
Evidence & Limitations
근거·검증 범위·업데이트 기록
확인한 근거
GitHub Actions 빌드·테스트 공식 문서를 기준으로 핵심 사실을 확인하고, 사실과 편집부 해석을 구분했습니다.
경험 정보와 한계
직접 사용 후기나 자체 성능 시험이 아닌 공개 원문·공식 문서 기반 분석입니다. 실제 화면과 기능은 계정·기기·배포 시점에 따라 다를 수 있습니다.
게시·수정 기록
최초 게시 2026.09.09 15:05 · 최종 수정 2026. 09. 09.
전문 검토 영역
IT 매거진 편집부가 AI·소프트웨어·개발·모바일·보안·테크 비즈니스 관점에서 구성하고 팩트체크 데스크가 출처와 표현을 검토했습니다.
Related Articles
이 주제를 더 깊게 읽어보세요
현재 기사와 연결되는 배경·기술·시장 분석을 골라 바로 이동할 수 있습니다.